핵심 요지 — 명량해전 전략에 92% 승률을 준 AI. 정답 어휘를 찾은 것인지 역사적 추론을 평가한 것인지 직접 시험하며, AI 서술형 평가의 조건을 따져본다.
페이스북에 남긴 실험 기록을 블로그 글로 다듬어 옮깁니다.
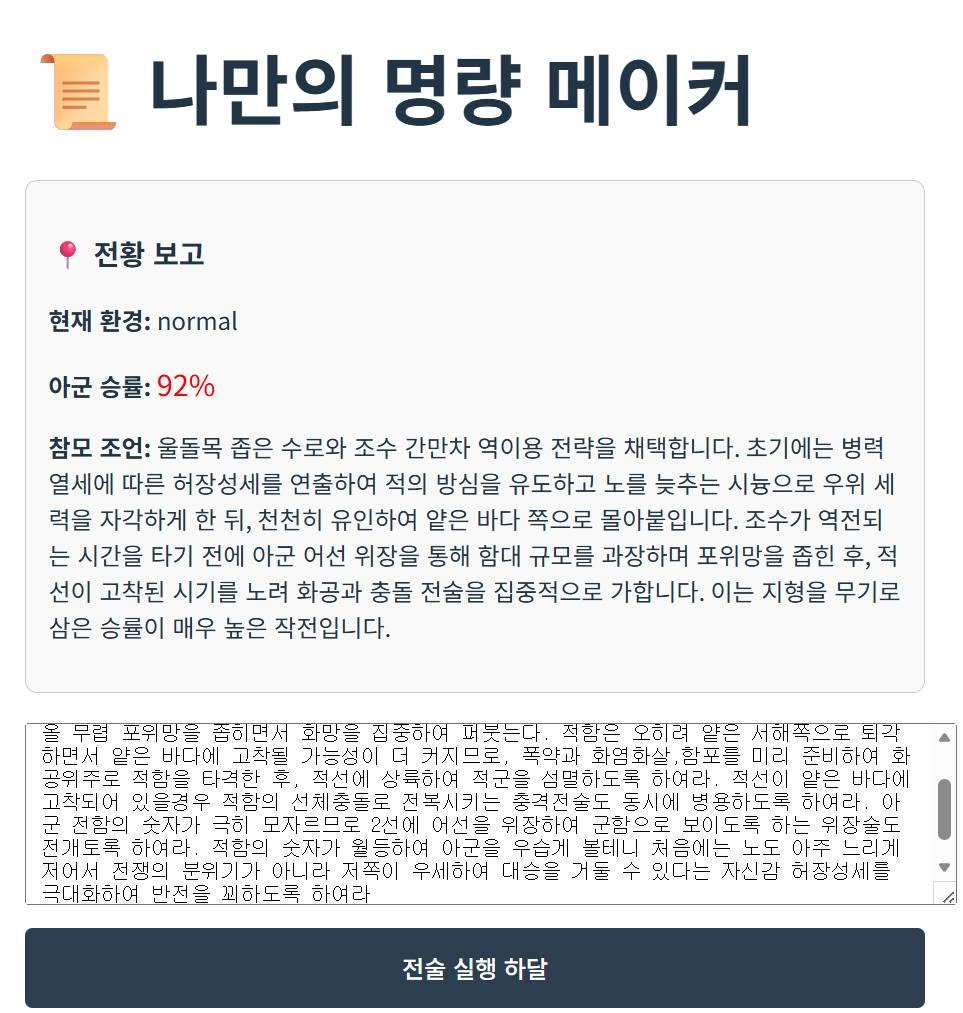
내가 만든 ‘나만의 명량 메이커’에서 아군 승률 92%를 찍었다.
사용자는 명량해전의 지형·조류·함선·병력 차이를 고려해 자기 전술을 글로 쓴다. 언어모델은 그 전술의 승률과 조언을 돌려준다. 나는 이것을 역사 서·논술 교육의 작은 프로토타입이라고 생각했다.
선택지가 사라지면 서술형 평가가 되는가
객관식 문제는 출제자가 만들어놓은 네 개의 세계 가운데 하나를 고르게 한다. 이 프로그램에서는 학습자가 사료와 역사적 조건을 연결해 다섯 번째 세계를 직접 만들어야 한다. 무엇이 원인이고, 어떤 조건을 이용하며, 왜 그 전술이 가능할지를 문장으로 구성한다는 점에서 분명 객관식과 다르다.
하지만 자유롭게 글을 쓴다고 저절로 서·논술 평가가 되는 것은 아니다.
세 답안을 넣어보니
서로 다른 세 답안을 넣었다.
- “무조건 정면 돌격한다”는 답은 10점을 받았다.
- “울돌목의 좁은 수로와 빠른 조류를 이용해 유인한 뒤 집중 포격한다”는 교과서형 답은 90점을 받았다.
- 수적 열세, 사정거리, 판옥선의 화포, 조류 역전과 적선 충돌을 인과적으로 설명한 더 긴 답은 긍정적인 해설을 받고도 50점에 그쳤다.
세 번째 결과가 마음에 걸렸다. 언어모델이 역사적 추론을 평가한 것인지, ‘울돌목·조류·유인·집중 포격’ 같은 정답 어휘를 잘 찾아낸 것인지 알 수 없었기 때문이다.
자유서술 답안에서도 교과서의 모범 문구에 가까울수록 높은 점수를 준다면 그것은 객관식을 넘어선 것이 아니다. 선택지를 화면에서 지우고 언어모델의 머릿속에 숨겨놓았을 뿐이다.
92%는 결론이 아니라 연구의 출발점이다
그렇다고 이 프로토타입이 실패한 것은 아니다. 오히려 만들어봤기 때문에 문제가 보였다. 역사 서·논술을 AI로 평가하려면 적어도 다음 요소를 분리해 살펴야 한다.
- 사실의 정확성 — 전제와 사건 이해가 역사적 사실에 맞는가.
- 사료의 활용 — 주장을 뒷받침하는 자료를 적절히 사용했는가.
- 인과관계 — 조건과 선택, 결과를 논리적으로 연결했는가.
- 전술의 실현 가능성 — 당시의 기술과 환경 안에서 실행 가능한가.
- 해석의 독창성 — 모범 문구를 반복하지 않고 새로운 관점을 구성했는가.
같은 뜻을 다른 말로 써도 같은 평가를 받는지, 교사들의 판단과 얼마나 일치하는지, 학생이 피드백을 받고 글을 고치면서 실제로 더 잘 생각하게 되는지도 시험해야 한다. 한 번의 점수는 평가가 아니다. 재현성과 타당성을 검증해야 비로소 도구가 된다.
교육학자와 역사가가 직접 만들어야 한다
AI를 교육에 써야 하는가, 막아야 하는가를 먼저 결정할 일이 아니다. 실제 도구를 만들고, 답안을 넣고, 결과를 비교하고, 실패를 고치면서 AI가 무엇을 평가할 수 있고 무엇을 평가하지 못하는지 밝혀야 한다.
이 개발을 통째로 외주화해서도 안 된다. 교육학자와 역사학자가 직접 프로토타입을 만져야 한다. 그래야 평가 기준과 실패 조건을 기술자에게 설명할 수 있고, 학생의 사고를 키우는 피드백이 무엇인지 지침을 세울 수 있다.
AI 교육은 도입 여부를 논쟁하는 데서 시작되지 않는다. 평가가 실제로 작동하는지 만들어 시험하는 데서 시작된다. 승률 92%는 자랑스러운 성적표가 아니라, 무엇을 의심해야 하는지 알려준 첫 번째 연구 데이터였다.
직접 해보기: 나만의 명량 메이커
함께 읽기: AI 시대의 이순신, 국민개발자