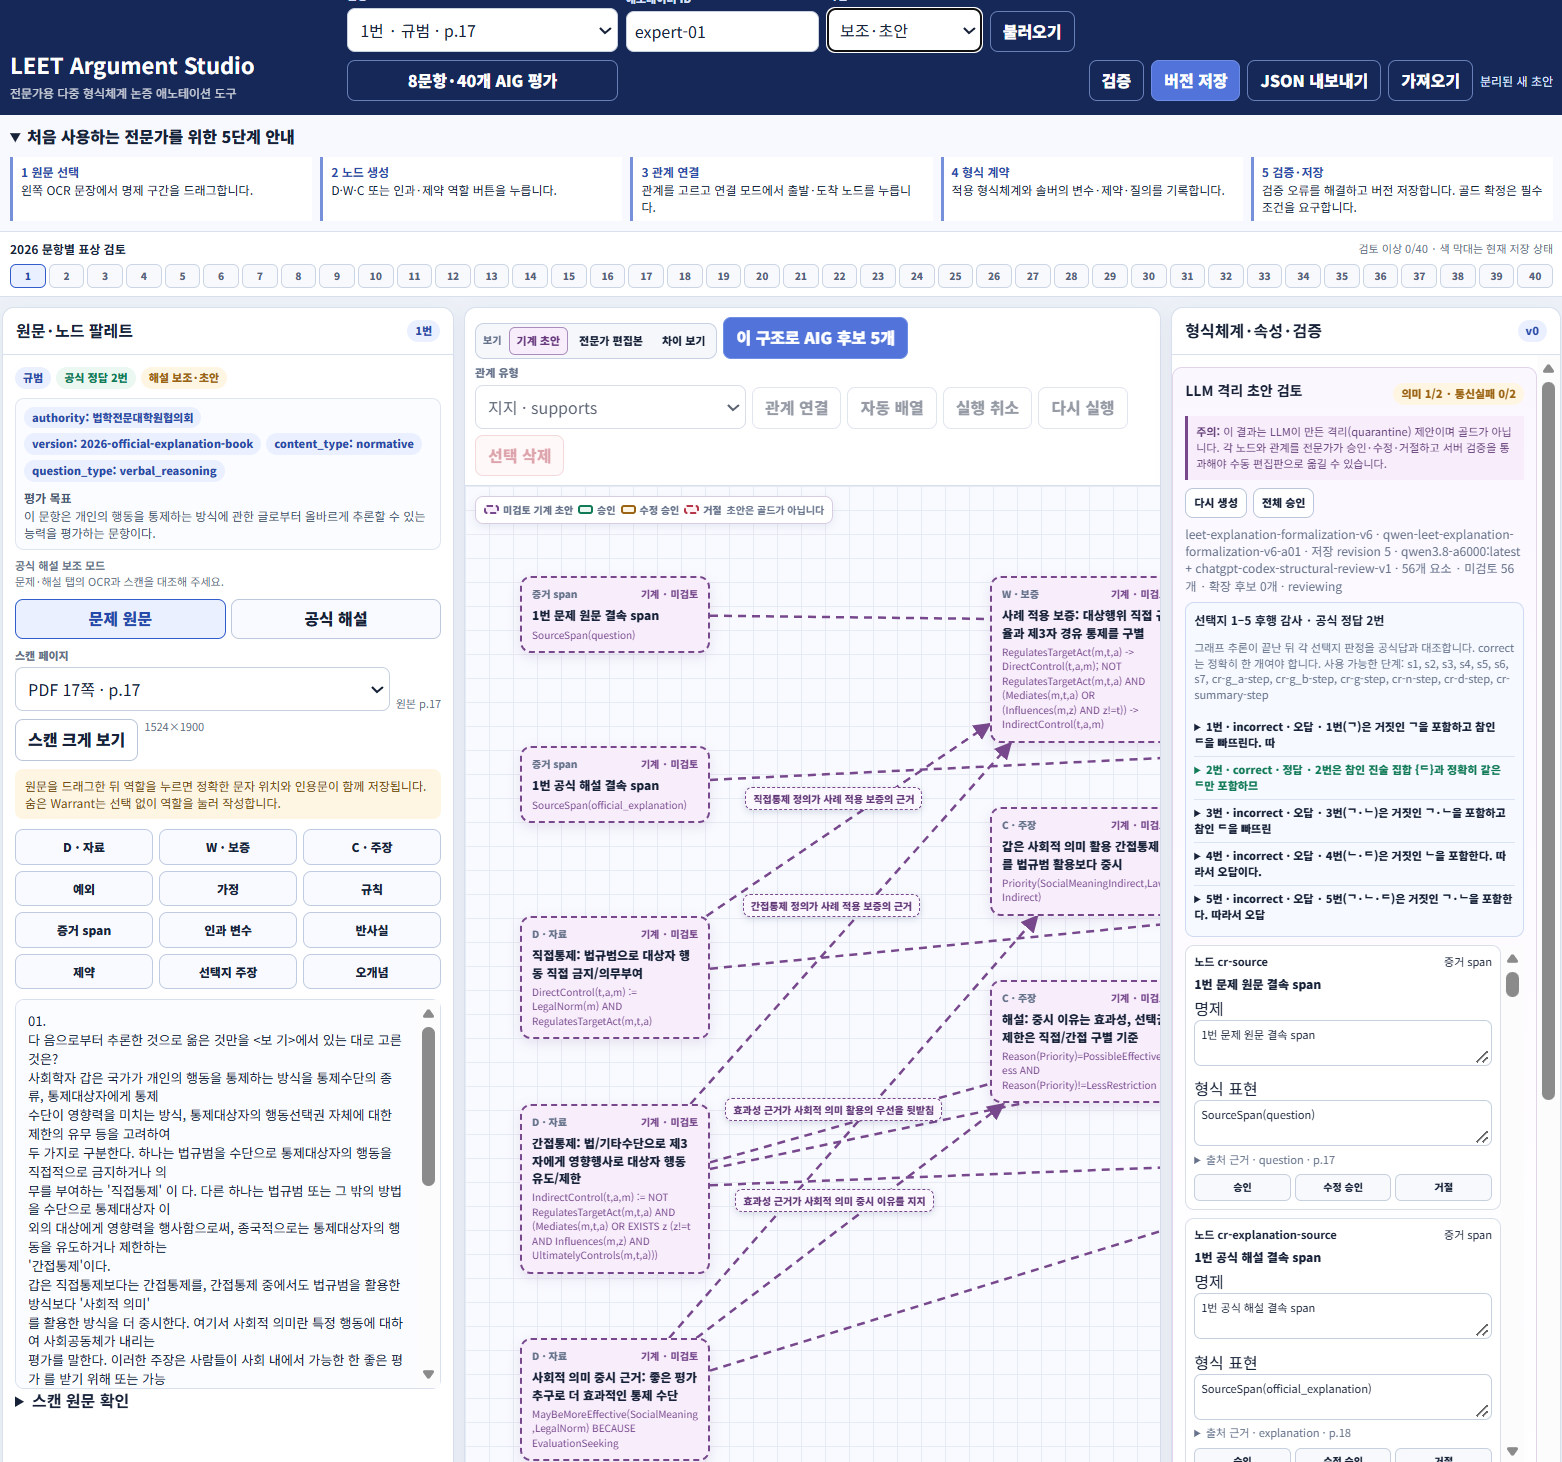
핵심 요지 — 법률 AI의 핵심을 정답 생성이 아니라 사실·규범·인과·반론의 관계를 드러내는 일로 다시 정의하고, 한국형 계산 법학의 방향을 모색한다.
1993년, 복학한 법대 3학년의 민법총칙 성적은 C+였다. 법을 컴퓨터로 다루고 싶다는 생각은 있었지만, 얄팍한 지식으로는 생각이 자라지 않았다. 졸업 뒤 부동산등기 프로젝트와 언어처리 회사에서 일했고, 자연언어 이해가 언젠가 법률의 문을 열 것이라는 기대는 오래 묵었다.
정답보다 어려운 것은 ‘왜’다
오늘의 대형언어모델에 변호사시험 문제를 주면 그럴듯한 답안을 낸다. 그러나 법적 추론의 핵심은 결론만 맞히는 데 있지 않다. 어떤 사실을 중요하게 골랐는지, 어느 규범을 적용했는지, 반대 해석을 왜 배제했는지 설명해야 한다. 같은 사건도 법률가와 문화권, 판례의 축적에 따라 논증의 길이 달라진다.
그래서 내가 다시 꺼낸 것이 주디아 펄의 인과추론이었다. 법률 추론과 인과추론을 섞어 2025년 변호사시험 문제를 풀고, 인과관계를 중심으로 설명하며 지식그래프로 그려 보라고 AI에 주문했다. 정답을 대신 쓰게 하려는 것이 아니라, 답에 이르는 관계를 눈앞에 펼쳐 보려는 시도였다.
법률 AI의 단위는 문장이 아니라 관계다
법률 문서에는 사람이, 행위가, 시간과 의무가 등장한다. “누가 무엇을 했는가”만으로는 부족하다. 그 행위가 어떤 의무를 만들었는지, 손해와 결과 사이에 어떤 인과가 있는지, 예외 규정이 어느 조건에서 작동하는지를 연결해야 한다.
계산 법학의 좋은 도구는 판례를 많이 외운 챗봇이 아니다. 사실–규범–주장–반론–결론의 연결을 드러내고, 사용자가 그 연결을 수정할 수 있게 해야 한다. 지식그래프는 장식이 아니라 논증의 누락을 찾는 지도다. 인과모형은 판결을 자동화하는 공식이 아니라 “다른 조건이었다면 결과가 달라졌는가”를 묻게 하는 사고의 장치다.
한국 법률의 추론 흔적이 필요하다
범용 모델의 추론 형식만으로 한국 법률가의 사고를 대신할 수 없다. 법률과 판례, 소송 실무, 한국어 법률 문장의 관습이 함께 들어가야 한다. 더 중요한 것은 완성된 답안뿐 아니라 왜 그 쟁점을 골랐고 어떤 반론을 검토했는지 보여 주는 추론의 흔적이다.
이 데이터는 시험 점수를 높이는 데만 쓰여서는 안 된다. 시민에게 판결과 계약의 이유를 설명하고, 학생에게 자기 논증의 약한 고리를 보여 주며, 전문가에게는 빠뜨린 반론을 되묻게 해야 한다. 사람을 배제하는 자동 판결기가 아니라 사람의 숙고를 더 투명하게 만드는 도구여야 한다.
오래된 가지가 물질이 되는 순간
15동 강의실, 서초동 법원행정처 프로젝트 사무실, 언어처리 회사, 읽다 만 인과추론 책은 오랫동안 서로 떨어진 기억이었다. LLM은 그 낱장 가지들을 한 번에 제품으로 만들지는 않는다. 다만 질문을 보고서와 그래프로 바꾸고, 다음 실험을 시작할 만큼 빠르게 물질화한다.
혼자라면 억만 년 제자리일 생각도 공동체와 도구를 만나면 진도가 난다. 계산 법학의 오래된 꿈은 법률가를 없애는 데 있지 않다. 법률가가 해 온 사유의 구조를 더 많은 사람이 보고, 질문하고, 고칠 수 있게 만드는 데 있다.
페이스북 원문: 〈계산 법학 computational jurisprudence〉 (2025년 5월 27일)